UN’INDAGINE CHE PUÒ CAMBIARE TUTTO
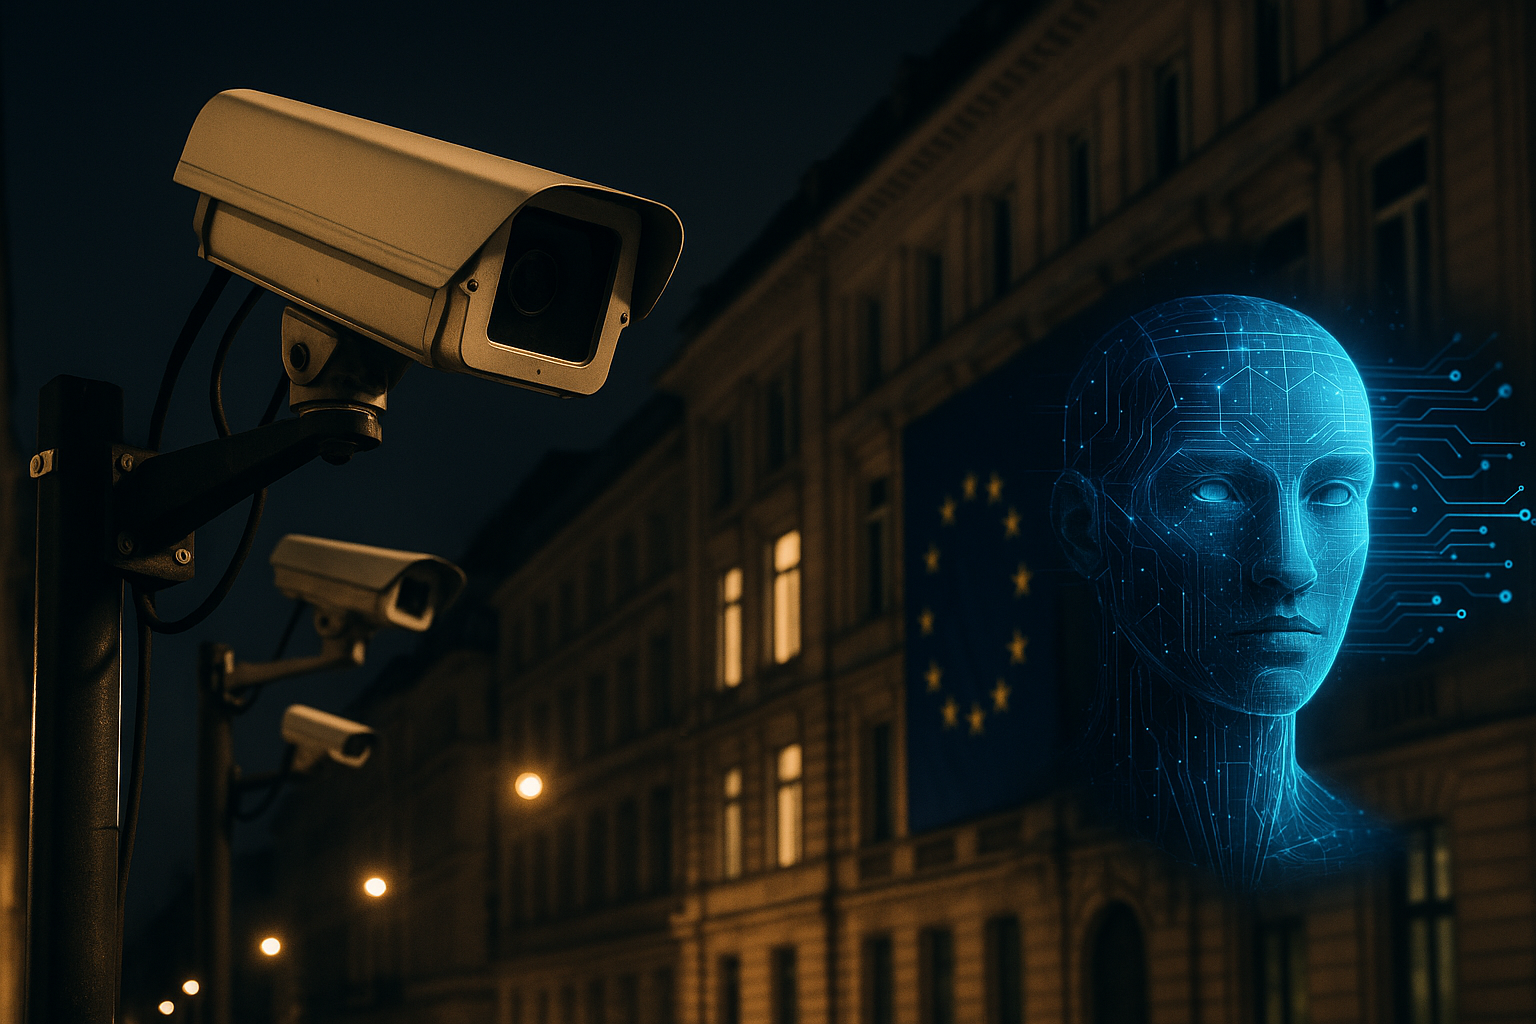
Negli ultimi mesi la Commissione europea ha aperto un dossier che potrebbe ridefinire il destino dell’intelligenza artificiale in Europa. Diversi modelli in circolazione sarebbero stati addestrati anche su dati provenienti da telecamere urbane, microfoni domestici e tracce biometriche raccolte senza alcuna base giuridica. Non si tratta di una semplice irregolarità tecnica, ma di una presunta violazione di massa del GDPR che potrebbe coinvolgere milioni di cittadini. L’Unione Europea ha scelto di muoversi in silenzio, ma la portata dell’indagine è enorme: capire se questi modelli siano legalmente utilizzabili o se l’intero settore sia costruito su fondamenta fragili. È una domanda che tocca la privacy, la tecnologia e persino la politica. L’Europa sembra decisa a non guardare dall’altra parte.
AZIENDE A RISCHIO SENZA SAPERLO
Molte imprese che utilizzano modelli di intelligenza artificiale non immaginano nemmeno il rischio a cui si stanno esponendo. Quando un sistema digitale nasce da un training basato su dati illeciti, ogni decisione che produce può trasformarsi in un problema legale. Se un algoritmo discrimina, sbaglia o danneggia un cliente, l’azienda che lo usa può essere ritenuta responsabile, anche se non ha partecipato all’addestramento. È una responsabilità a cascata che investe non solo chi sviluppa, ma anche chi integra e chi utilizza. Le aziende, convinte di adottare strumenti neutri e moderni, rischiano di scoprire troppo tardi che l’IA che usano, poggia su basi che non reggono un controllo giuridico serio.
QUANDO LO STATO USA MODELLI CHE NON PUÒ CONTROLLARE
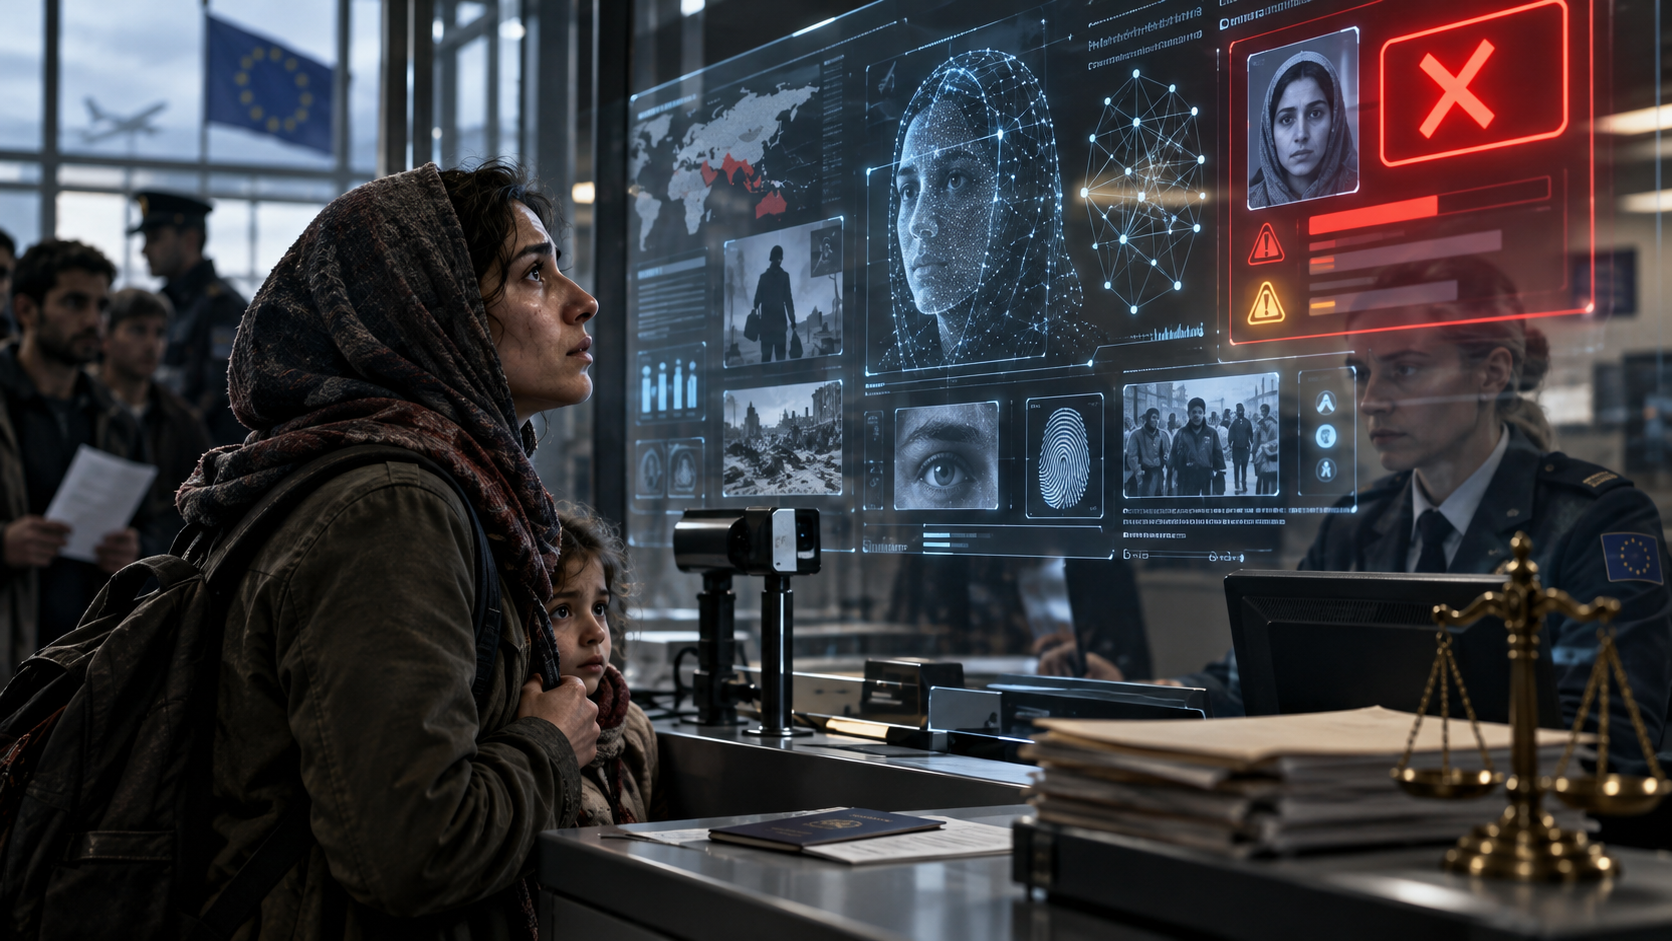
Il paradosso più inquietante riguarda il settore pubblico. Molte amministrazioni europee hanno incorporato intelligenza artificiale in ambiti delicatissimi come sicurezza, sanità, immigrazione e welfare, senza poter verificare davvero da dove provengano i dati usati dai fornitori. Questo crea uno scenario problematico: lo Stato, che deve proteggere i cittadini, rischia di utilizzare strumenti costruiti proprio attraverso la violazione dei loro diritti. Quando un algoritmo sbaglia, il cittadino non ha modo di ricostruire la logica interna del sistema o contestare il processo decisionale. L’indagine europea vuole capire se la pubblica amministrazione stia, senza volerlo, alimentando un nuovo modello di sorveglianza involontaria.
IL NESSO CAUSALE: IL BUCO NERO DELLA RESPONSABILITÀ
Il punto più fragile dell’intera vicenda riguarda la trasparenza: come dimostrare che un modello, addestrato anche su materiale illecito, ha prodotto una decisione distorta proprio a causa di quei dati? La catena causale nell’intelligenza artificiale è già complessa in condizioni normali. Quando i dataset diventano opachi, ricostruirla diventa quasi impossibile. Questo rischia di mettere in crisi le categorie tradizionali del diritto civile: senza poter collegare un danno al modo in cui il modello è stato addestrato, la tutela del cittadino diventa un percorso in salita. La tecnologia procede per correlazioni, il diritto per cause ed effetti. Questa differenza rischia di aprire un vuoto enorme nel sistema di responsabilità.
UNA MINACCIA SILENZIOSA PER IL MERCATO DELLE TECH COMPANY
Se l’indagine dovesse confermare le irregolarità, le conseguenze economiche sarebbero devastanti. Un modello addestrato in modo illecito potrebbe essere escluso dal mercato europeo, con ripercussioni su startup, fornitori, integratori e piattaforme che lo utilizzano. Gli investitori stanno osservando la situazione con crescente preoccupazione: temono che molti prodotti AI non siano realmente conformi e che il loro valore possa precipitare da un giorno all’altro. Dietro l’entusiasmo dell’intelligenza artificiale si nasconde un problema che pochi vogliono affrontare: non basta che un modello funzioni, deve essere costruito in modo legittimo e l’Europa sembra pronta a farlo valere.
IL QUADRO NORMATIVO È PIÙ RIGIDO DI QUANTO SI PENSI
L’AI Act, combinato con il GDPR, crea una tempesta perfetta. L’Europa non si limita a chiedere trasparenza: pretende documentazione verificabile, supervisione umana, controllo dei dataset e tracciabilità dell’addestramento. Se un sistema è stato alimentato con dati provenienti da sorveglianza illegale, non può essere considerato conforme. Questo significa che l’indagine in corso non riguarda solo un problema di privacy, ma la validità stessa di molti modelli oggi utilizzati. In altre parole, l’Europa sta dicendo chiaramente che innovare non dà diritto di violare le regole. Chi non potrà dimostrare la correttezza del training rischia di essere tagliato fuori.
UN FUTURO CHE CHIEDE CORAGGIO E TRASPARENZA
L’Europa sta entrando in una nuova fase in cui l’intelligenza artificiale dovrà essere non solo potente, ma anche verificabile e responsabile. Il punto non è fermare la tecnologia, ma evitare che diventi una forza incontrollabile capace di incidere sulla vita delle persone senza alcuna supervisione. La Commissione sembra orientata a un modello in cui la trasparenza del training, la tracciabilità delle decisioni e la responsabilità multilivello saranno criteri essenziali per operare nel mercato europeo. È una scelta che richiede coraggio, ma anche una visione chiara: non può esserci innovazione senza fiducia, e non può esserci fiducia senza il rispetto dei diritti. Il futuro dell’IA in Europa dipende da questa linea sottile.
A cura degli studenti sotto la facoltà di Giurisprudenza e Ingegneria Informatica